DeepSeek-V4.1-Flash-1017 搭配 Hermes 使用 REA 逆向智能音箱实现家庭助理贾维斯
来源:DeepSeek-V4.1-Flash-1017 搭配 Hermes 使用 REA 逆向智能音箱实现家庭助理贾维斯
DeepSeek-V4.1-Flash-1017 搭配 Hermes 使用 REA逆向智能音箱实现家庭助理贾维斯
手上都是面粉的时候,最烦的是找开关。
现在的做法是抬头说一句:开客厅灯,放首歌。灯亮,音乐起。做饭中途想换一首,喊一声名字,音乐停住,说完「换一首周杰伦的」,新歌接上,不用洗手。
这台音箱两百块出头,某智能音箱 Pro。唤醒词是「你好小瑞」。
它现在管着家里 59 个开关、3 盏灯、10 幅窗帘、5 个场景,看着 5 个摄像头;放歌的时候,去自己 NAS 上的曲库找。Home Assistant 里 423 个实体,能被一句话点到的部分,都在它手上。
三件事值得单独说。
01 第一件:全屋的设备,只要进得了 Home Assistant,它就控得住
不是「支持某某品牌几十款设备」那种白名单。门槛只有一个:设备能接进 Home Assistant。
灯、开关、窗帘、场景、脚本、媒体播放,一句话的事。客厅主灯在系统里其实是两个开关——墙上是双控——这种坑得提前告诉它,不然它只开一半。
后台还接了 MCP。Hermes 的工具层能直接调 Home Assistant 的接口,意思是家里每多接一个设备,助理就多一项能力,不用改一行代码。这个口子开出来,往后能长成什么样,现在只能算想象。
02 第二件:它的脑子是我们自己的,这才是最大的不一样
市面上的智能音箱,模型在厂商的云里。模型是哪一版、什么时候换、能记住什么、说话什么口吻,你说了不算;而且你说的每一句话,都要先在它的服务器上跑一遍。
这套反过来。后端是 DeepSeek-V4.1-Flash-1017 加 Hermes harness,模型自己选、音色自己换、提示词自己写、对话历史留在自己手里。今天觉得不够聪明,换一个更强的模型;明天想彻底不出门,把模型地址指向本机就行。
一句话里带两个意思——「把客厅灯打开,放首歌」——它自己拆成两次调用;说得含糊——「有点吵」——它去调音量,而不是反问。这种理解力,是这一代模型才有的。
它的声音也不是机器念稿的调子:音色是换过的,想换成谁的、什么腔调,都在自己的配置里。
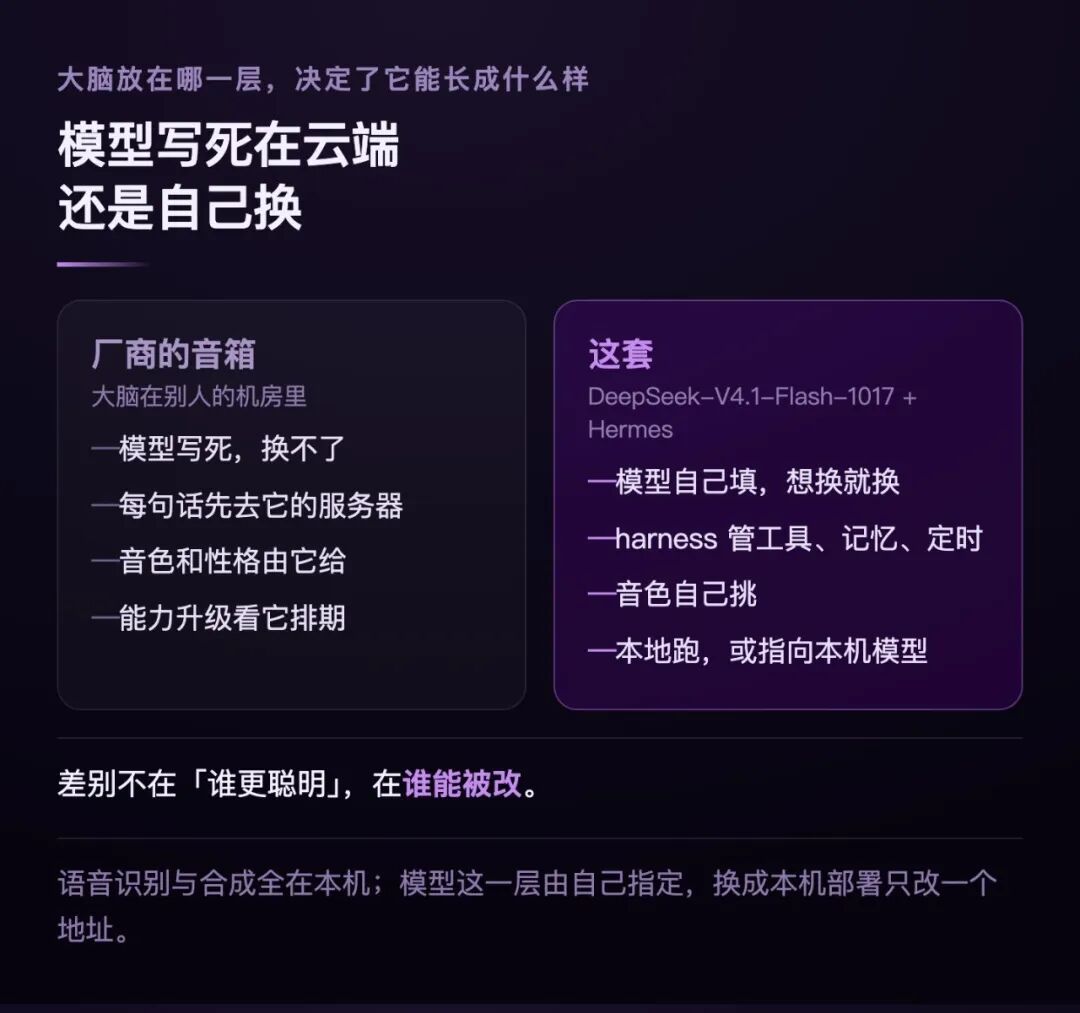
两种架构:一层是模型写死在厂商云端,一层是自己的 harness 换模型换音色
03 第三件:它还有好几双眼睛
局域网里凡是接了摄像头的地方,它都能看:门口、客厅、卧室、浑南那套房子,各有各的名字,说地名就行,不用记实体编号。
室外的机器本来只在厂商的 App 里能看到,没有任何公开接口。它也是用 rea 接进来的:把固件拆开,找到它监听的地址,接进局域网。
现在问一句「门口有人吗」,它抓一帧画面回答你。
04 但第三方方案有个通病:一放歌就聋
这一段是整件事的技术核心,也是为什么开源方案到现在还不好用。
「放歌的时候还能插话」,官方固件是能做到的。它和自己的声学前端是一套东西,知道什么时候该让路。
第三方做不到。比如 open-xiaoai:音频接得出来,一放歌就聋,音量越大越聋。原因是它拿不到声学前端的配合,参考信号不准,回声减不干净。
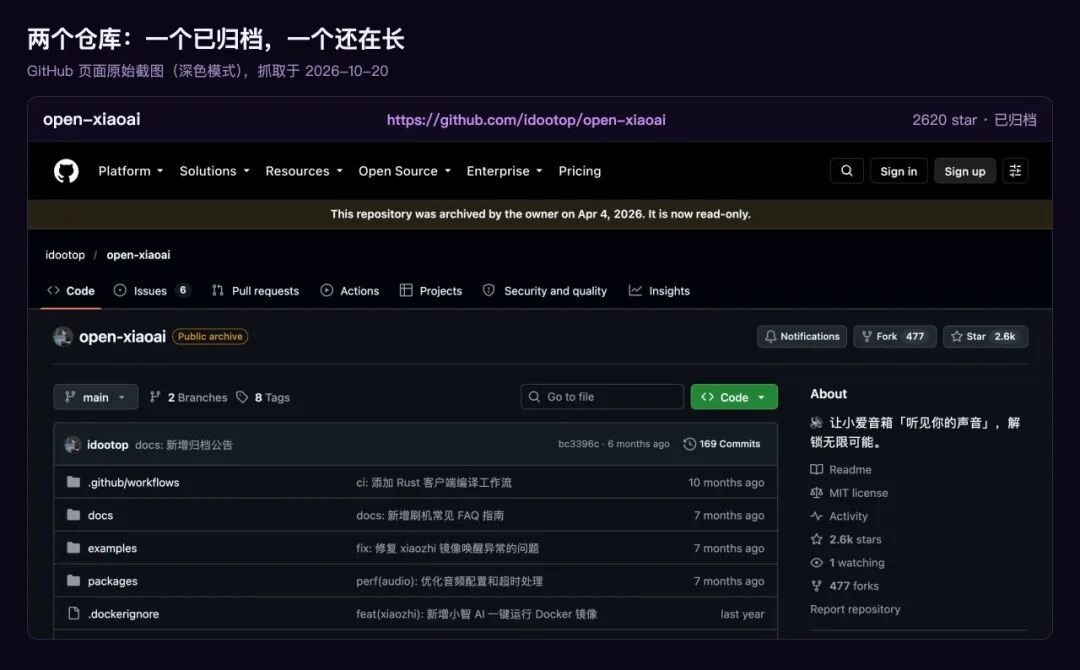
open-xiaoai:把音箱的耳朵和嘴接出来的开源项目
我们先按常规调:换识别方案、换唤醒词、加长滤波、调门限,全撞墙。现象里有一条很硬的线索——安静时全好,一放歌就废。问题不在「认不认得这句话」,在送进去的声音本身已经不干净。
于是把固件拆开。用的就是 rea。
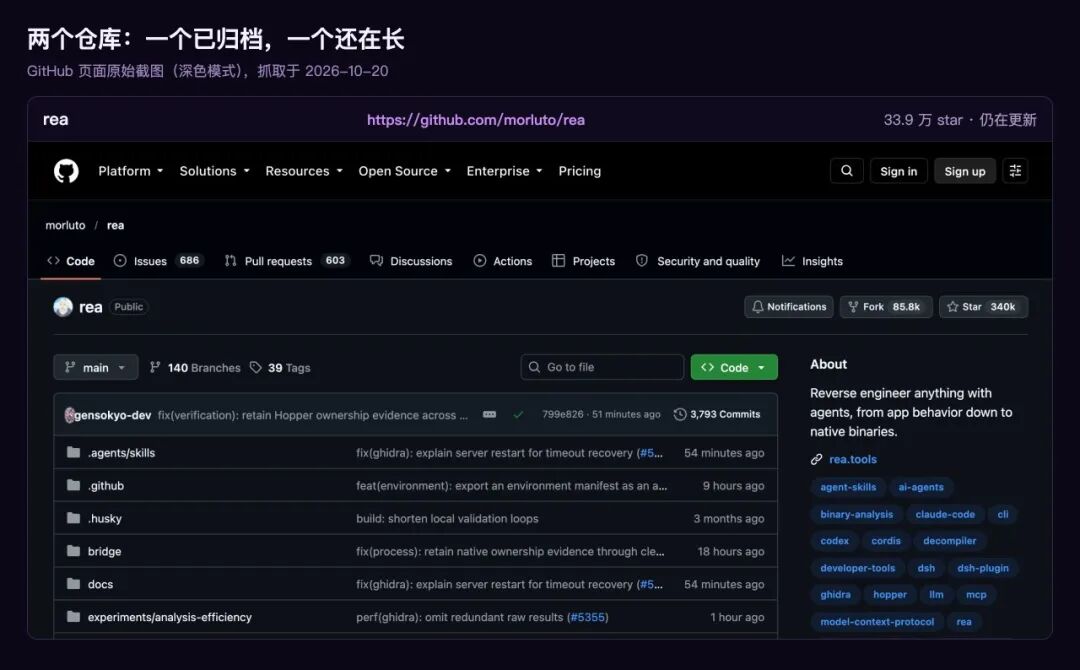
rea:让智能体自己读反汇编、找调用链、验证假设
结论很尴尬:厂商的回声消除算法,和我们后来换的 speexdsp 一模一样——16 kHz 采样、4096 个抽头、6 个麦克风各一路。算法这一层,厂商没有秘密,也没有留一手。
问题在数据。设备一次给出 8 路 32 位音频:ch0 到 ch5 是 6 个麦克风,ch6 和 ch7 是同一路「播放参考」——硬件回环,和播放内容的相关性是 1.000,比麦克风收到的声音早 2.4 毫秒。两组的满量程不一样:麦克风是 2²³,参考是 2²⁸,差 32 倍,正好 5 个二进制位。
客户端为了把 32 位压成 16 位,写了一句对所有通道统一生效的 >>8。对麦克风,8 位刚好;对参考通道,这一刀砍在了骨头上——音量 110 的时候,参考有 52% 的采样被削顶;音量 170 的时候,是 78%。
参考被削平,等于拿一张过度曝光的照片去修图。回声消除拿它去做减法,减不干净,剩下的全是自己的歌声。
改成按通道分别缩放——麦克风 >>8,参考 >>13——削顶降到 0.7% 以下。代码上是三个常量和一次函数签名改动。
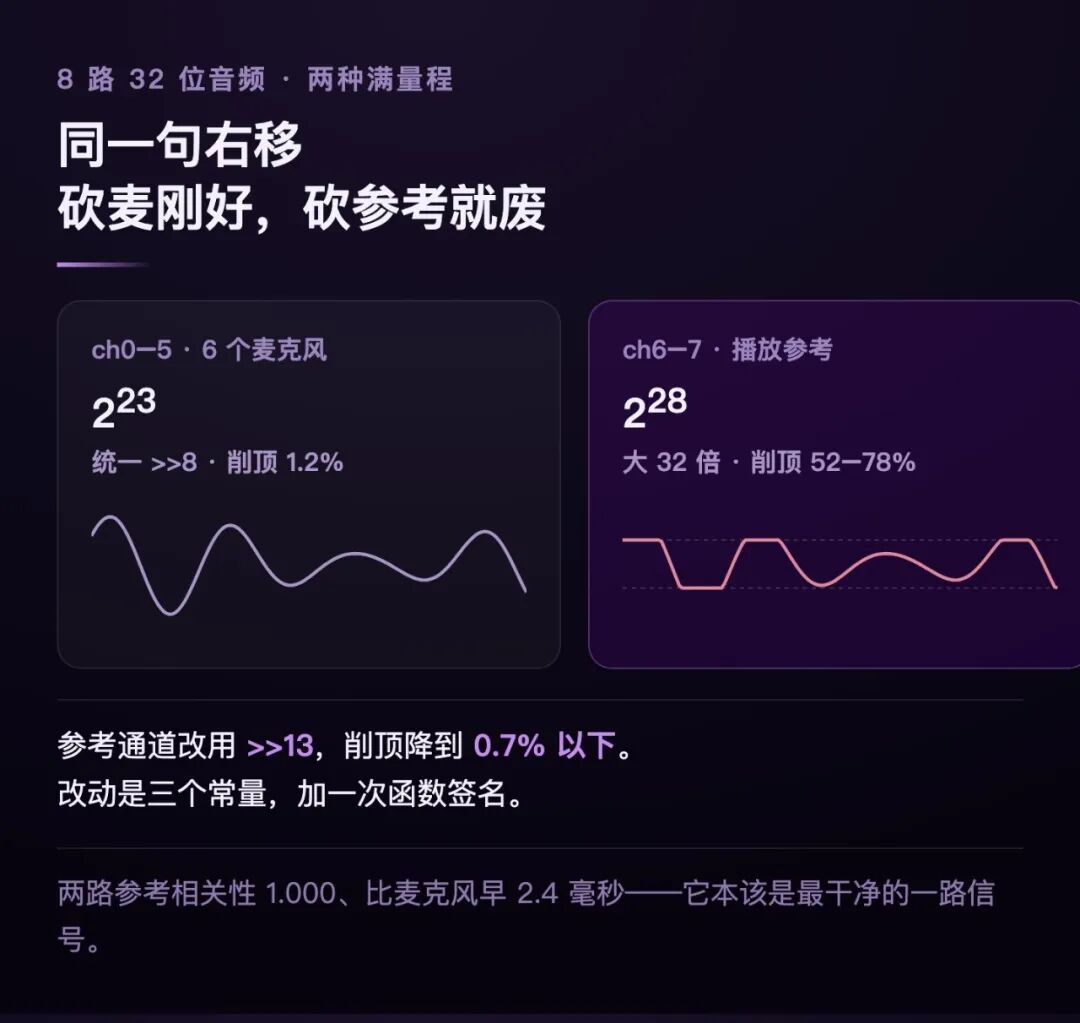
修前的参考波形:波峰被压成直线
同一段音乐、同一条链路、同一套算法,只改缩放:音量 110,修前 5.5 dB,修后 23.0 dB;音量 170,修前 4.4 dB,修后 25.2 dB。设备日志里实跑是 23.4 dB 和 30.2 dB,修之前同一时段只有 8 到 12 dB。
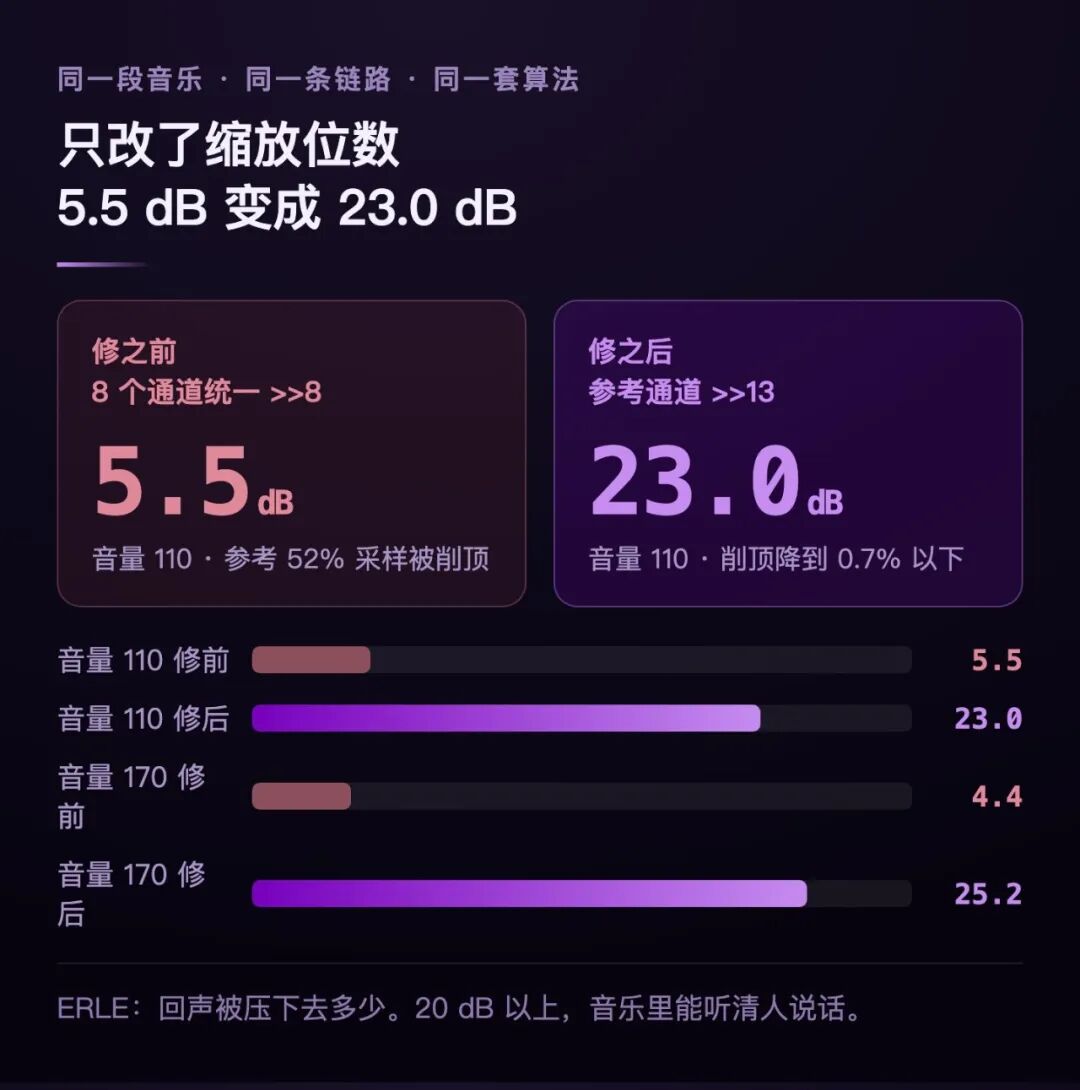
同一套算法,只改缩放位数:5.5 到 23.0 dB
20 dB 以上,音乐里就能听清人说话。现在放到八成音量,喊「你好小瑞」当场停歌,说完再自己接回去——以前这件事得靠遥控器。
05 它在我家的位置:一个通话入口,一个家庭中枢
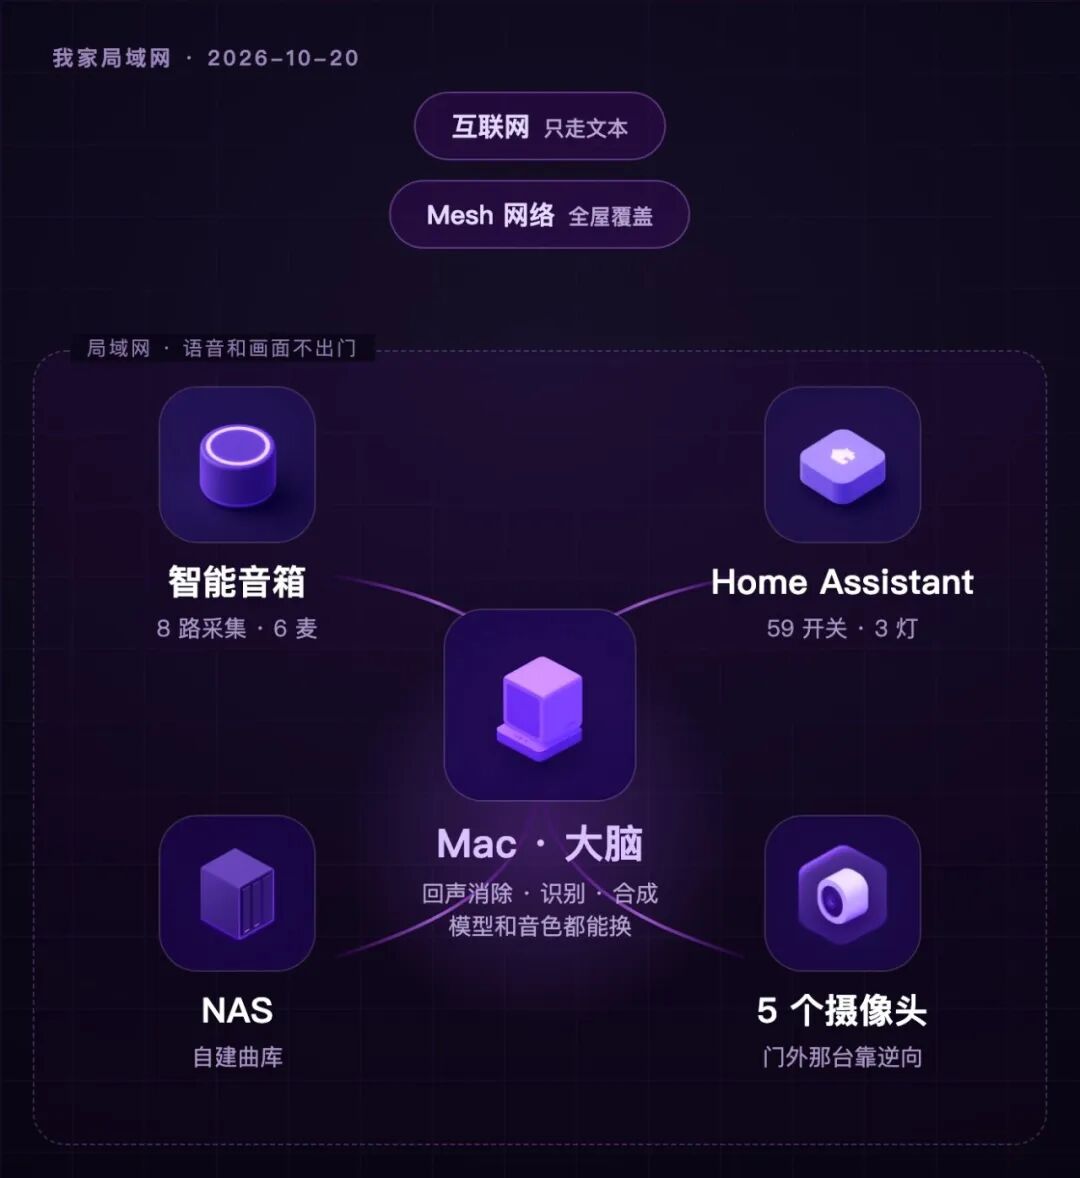
我家局域网:Mesh、Home Assistant、音箱、NAS、摄像头,都在一个网里
最上面是互联网,只走文字请求——语音不出门,画面不出门。
下面是 Mesh,全屋覆盖;再下面是局域网:一台跑 Home Assistant 的小主机,一台存歌的 NAS,一台跑模型和语音服务的 Mac,一台音箱,五个摄像头。开关、灯、传感器、窗帘都挂在 Home Assistant 下面。
链路是这样走的:说话进音箱,8 路音频在局域网里送到 Mac,回声消除、唤醒、识别、理解,要控设备走 HA,要放歌去 NAS,要看画面去摄像头。全部在本地。
理论上,它就是一个通话入口:家里人对着音箱说一句,在外面的人能听见、能回答,反过来也一样。零件都是现成的,还没做,先记在这里。
06 门槛和分寸
花费很低:音箱两百块,模型按用量付费,一天几十次对话不到一杯咖啡。剩下全是时间。
真正难的不是钱,也不是模型,是把音频链路磨到毫秒级——回声消除、参考信号、唤醒门限、打断时机,每一环都能让体验塌掉,而塌掉时不会报错,只会觉得「不好用」。
真正难的还有分寸:一个随时会开口的助手,比一个只会回答的助手,让人烦的概率高得多。
一年前,这台音箱的固件要一个团队拆几个星期。这次是 AI 自己读反汇编、自己找调用链,人只在关键处做判断。一个人、几天、两百块的硬件。
变化不是「AI 会聊天了」,是「原来做不了的事,一个人也能做了」。
口径说明:硬件参数取自设备固件与现场探测;回声抑制(ERLE)与端到端耗时为本机日志实测,单次测量,未做统计分布;实体数量取自 2026-10-20 的 Home Assistant 统计;模型参数以官方模型卡为准。改造涉及设备本地服务,可能影响保修,操作前请自行评估。
参考来源
01 GitHub,idootop/open-xiaoai(已归档,2620 star):https://github.com/idootop/open-xiaoai
02 GitHub,morluto/rea:https://github.com/morluto/rea
03 GitHub,idootop/open-xiaoai-kws,2025
04 Speex 项目文档,speex_echo_state_init / MDF 自适应滤波
05 Home Assistant 开发者文档,Service 调用与实体模型
06 Subsonic API 文档,search3 / stream 接口
07 DeepSeek API 文档,chat completions 与工具调用
#人工智能 #开源 #智能体 #智能家居 #逆向工程