图片验证码识别插件嫁接视觉大模型:captcha-killer-modified AI 增强版(长歌二开)
一句话:ddddocr 打不动的强干扰算术验证码,换成「本地快通道 + 视觉大模型投票 + 本地兜底」后 5⁄5 全对,单张 0.8–2 秒,首次请求也从 12.7s 压到 2.5s。Burp 用 captcha-killer 接入,Yakit WebFuzzer 用热加载接入,两者共用同一个识别服务。
原作:f0ng/captcha-killer-modified 的
codereg-1.py二开:长歌(2026-10-23),新增视觉大模型通道、投票、预处理、预热、采样落盘
一、问题:ddddocr 为什么全错
从 Burp 历史里切出 5 张真实验证码逐字比对:
| 真实验证码 | 正确答案 | ddddocr 原始输出 | 最终结果 |
|---|---|---|---|
| 20+7 | 27 | 20t1 / 2(t7 |
错 |
| 29+3 | 32 | 29*3 |
算成 87,错 |
| 19+3 | 22 | )*37 |
错 |
| 28+8 | 36 | 28x87 |
错 |
| 21+7 | 28 | 2+7 |
算成 9,错 |
根因两条:
+被读成*。20+7被算成 140、29+3被算成 87。这类错误最隐蔽——表达式语法合法,程序不会报错,只是答案错,验证码一直不过还查不出原因。- 字符本身丢失。字符随机旋转、逐字变色,再叠加彩色曲线与灰色圆点,
19+3直接被读成)*3,连解析都过不了。
ddddocr 的通用模型训练分布是「4–6 位字母数字」的规整验证码,这种「旋转彩色算术题」属于分布外样本。两条路:一是攒样本微调 ddddocr(工程量大、要标注),二是直接把读图这步交给视觉大模型(当天可用)。这里走第二条,同时把样本自动存下来,为以后微调留数据。
二、方案
                  base64 图片
                        │
                        ▼
        ┌───────────────────────────────┐
        │ 1. ddddocr beta + std 双模型  │
        └───────────────┬───────────────┘
                两模型一致且可解析?
                ├── 是 ──→ 本地求值 → 返回数字(约 20ms)
                └── 否
                        │
                        ▼
        ┌───────────────────────────────┐
        │ 2. 预处理:放大 + 对比 + 锐化 │
        │    视觉模型并行投票 ×2         │
        │    两票不一致再补第 3 票       │
        └───────────────┬───────────────┘
                多数票表达式可解析?
                ├── 是 ──→ 本地安全求值 → 返回数字(1–3s)
                └── 否 ──→ 让模型直接给答案 → 本地结果兜底
三个关键取舍:
- 模型只负责“读”,不负责“算”。模型输出
20+7,四则运算由本地 AST 白名单求值。大模型算错20+7这种事不必赌。 - 投票而不是单次。
temperature=0也有抖动,两票一致才采信,不一致补第三票,宁慢一次不赌一次。 - 关掉思考模式。qwen3.8-flash 这类推理模型默认把 token 全烧在 reasoning 上,
content直接为空;请求里带chat_template_kwargs.enable_thinking=false与thinking.type=disabled后,单次从 6–17s 降到 0.7–2s,输出稳定 5 个 token。
三、实测
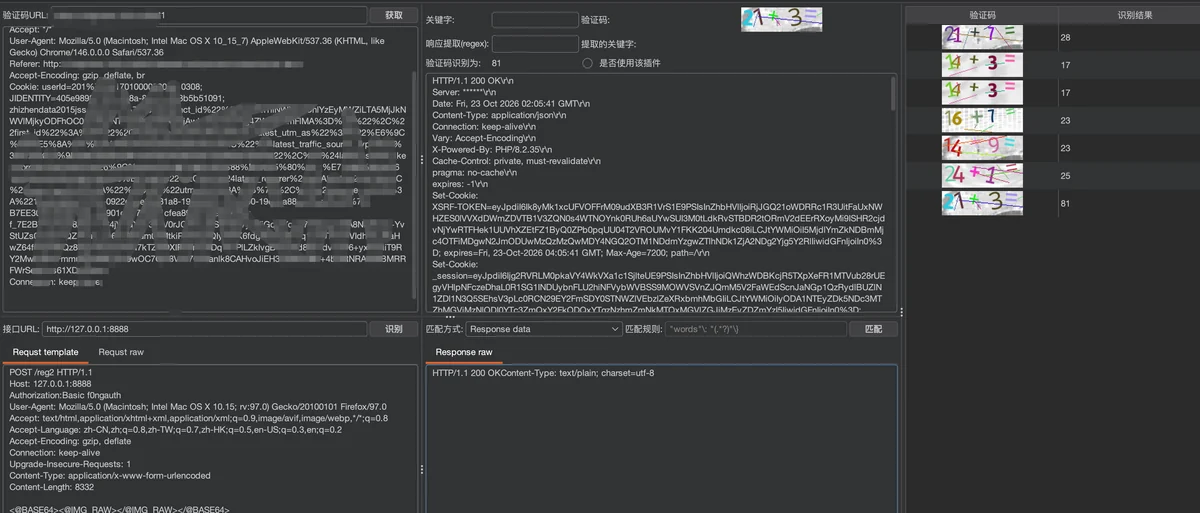
Burp 里连着打 7 发,识别结果列全部是算好的答案(28 / 17 / 17 / 23 / 23 / 25 / 81),没有再出现把 + 当 * 的情况。左侧 Cookie 已打码。
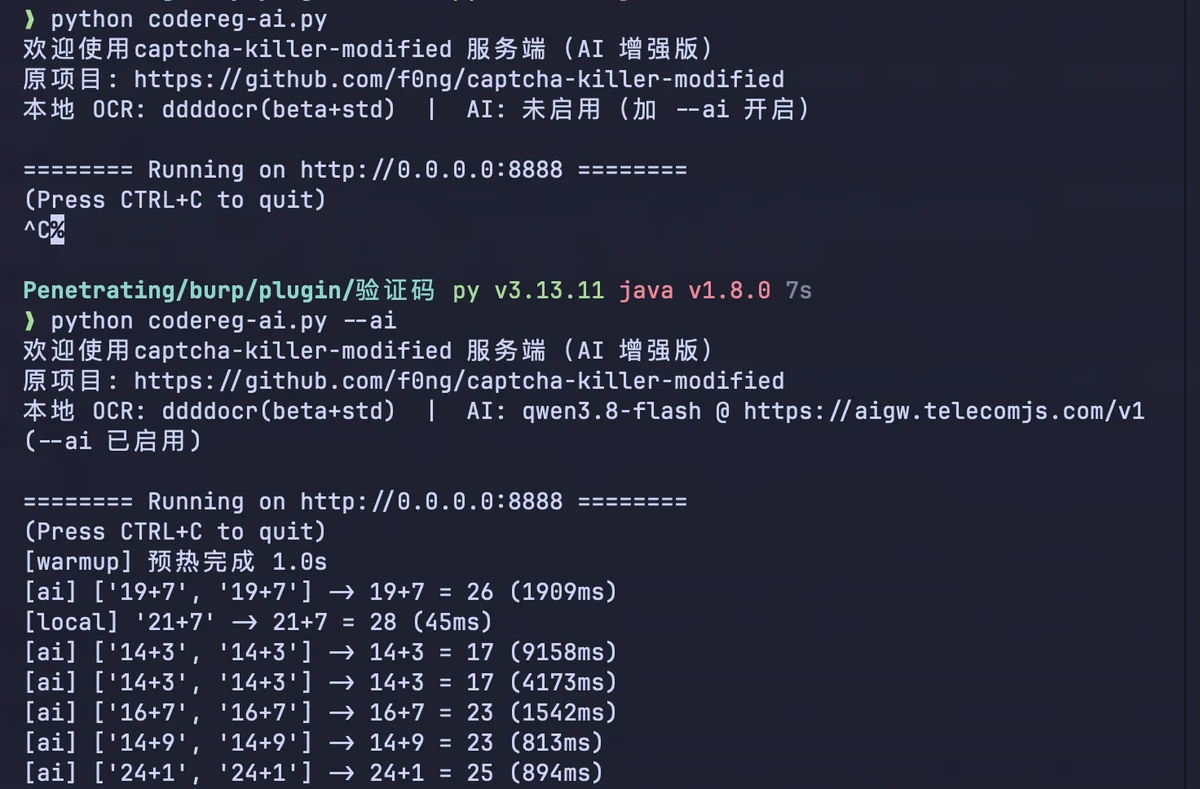
日志能直接看出两条通道的分工:
[local] '21+7' -> 21+7 = 28 (45ms):本地双模型恰好一致,毫秒级返回,不花一分钱调用;[ai] ['19+7','19+7'] -> 19+7 = 26 (1909ms):本地判不了,两票一致直接采信;- 偶发
9158ms:网关抖动,投票机制兜住了正确性,只是慢一点。
7 张里本地快通道命中 1 张,其余 6 张走 AI,全部正确。
四、部署与配置
1. 环境
python3.13
pip install ddddocr aiohttp pillow
实测环境:Python 3.13.11 / ddddocr 1.6.1 / aiohttp 3.13.5 / onnxruntime 1.28.0 / opencv-python 5.0.0.93。ddddocr 首次运行会自行下载模型(十几 MB),离线机器要提前放好。
2. API Key(脚本内已移除,必须自己配)
这个版本不在代码里内置任何密钥。--ai 模式取 key 的顺序是:命令行 --api-key > 环境变量 CAPTCHA_AI_KEY;两者都没有会直接报错退出,不会静默降级。
export CAPTCHA_AI_KEY=sk-your-key              # --ai 必填
export CAPTCHA_AI_BASE=https://your-gateway/v1 # 可选,OpenAI 兼容端点
export CAPTCHA_AI_MODEL=qwen3.8-flash          # 可选,多模态模型 id
| 环境变量 | 必填 | 默认 | 说明 |
|---|---|---|---|
CAPTCHA_AI_KEY |
--ai 时必填 |
无 | 端点 API Key,脚本不内置 |
CAPTCHA_AI_BASE |
否 | https://aigw.telecomjs.com/v1 |
需支持 POST /chat/completions 且接受 image_url 的 base64 data-uri |
CAPTCHA_AI_MODEL |
否 | qwen3.8-flash |
必须是多模态模型 |
CAPTCHA_AI_TIMEOUT |
否 | 20 |
单次请求超时(秒) |
CAPTCHA_SAMPLE_DIR |
否 | samples |
采样落盘目录 |
换成本地 vLLM + Qwen2.5-VL 之类时,只改 CAPTCHA_AI_BASE 与 CAPTCHA_AI_MODEL 即可,协议不用动。
3. 启动
python codereg-ai.py            # 不启用 AI:纯 ddddocr,毫秒级,不联网
python codereg-ai.py --ai       # 启用视觉大模型(读 CAPTCHA_AI_KEY)
python codereg-ai.py --ai -p 8888 --votes 3
默认端口 8888,与旧脚本完全一致;--ai 是开关,不加就是原来的行为。
4. Burp / captcha-killer-modified 侧
接口与认证都没变,把服务端脚本换掉即可:
- 接口 URL:
http://127.0.0.1:8888/reg2 - 请求模板:
POST /reg2 HTTP/1.1
Host: 127.0.0.1:8888
Authorization: Basic f0ngauth
User-Agent: Mozilla/5.0
Accept: */*
Content-Type: application/x-www-form-urlencoded
Content-Length: 8332

<@BASE64><@IMG_RAW></@IMG_RAW></@BASE64>
Authorization必须与脚本里的AUTH_HEADER(默认Basic f0ngauth)一致,否则 403;- 「匹配方式 / 匹配规则」按目标站点响应提取验证码字段,识别结果回填到请求里的
<@captcha>占位; - 目标是 https 时,抓取验证码图片的那条请求要允许 https(插件里的选项勾上)。
5. 命令行参数
| 参数 | 默认 | 说明 |
|---|---|---|
-p, --port |
8888 |
监听端口 |
--host |
0.0.0.0 |
监听地址 |
--ai |
关闭 | 启用视觉大模型;不加则纯 ddddocr |
--base-url |
环境变量/内置 | OpenAI 兼容端点 |
--api-key |
环境变量 | 端点密钥,优先级高于环境变量 |
--model |
qwen3.8-flash |
多模态模型 id |
--votes |
3 |
AI 投票次数,前两票一致提前返回 |
--no-local |
关闭 | 关掉 ddddocr,全走 AI(需配合 --ai) |
--no-warmup |
关闭 | 跳过启动预热 |
--selftest DIR |
无 | 离线批量自测目录,文件名带答案数字即可(如 27.png) |
五、接口
| 接口 | 方法 | 用途 | 返回 |
|---|---|---|---|
/reg2 |
POST | 算术验证码 | 计算结果数字 |
/reg |
POST | 普通字符验证码 | 识别文本 |
/reg00 … /reg06、/reg000 |
POST | 兼容旧脚本的分类识别 | 文本或计算结果 |
/reg2dbg |
POST | 调试 | JSON:本地原文、AI 原始票、表达式、答案、来源、耗时 |
/health |
GET | 探活 | JSON:模型、投票数、调用次数、失败次数 |
请求体统一兼容 base64 文本、data-uri 和裸二进制;响应都是 text/plain,Burp 直接取用。所有识别接口都尊重 ranges 请求头(0–6),不受当前走本地还是 AI 影响。
六、实现要点
- 预处理(
prep_for_ai):宽度小于 260 放大 2–4 倍,大于 520 缩到 520;再 autocontrast + UnsharpMask。实测小图放大后模型读数明显更稳。 - 投票(
VisionOCR.vote):并发发两票,一致即返回;不一致补第三票取多数。 - 安全求值(
safe_eval):AST 白名单只放行数字、括号与四则运算,拒绝一切函数调用与属性访问。 - 缓存:按图片 sha256 缓存 10 分钟、上限 512 条,重放同一张图不再花钱。
- 预热(
warmup):启动时用 1×1 白图打一发,建立长连接并触发网关冷启动——首个真实请求从 12.7s 降到 2.5s。 - 采样本(
_save_sample):每次 AI 成功识别,图片存samples/YYYYMMDD/,labels.tsv记录 AI 表达式、答案和本地 OCR 原文,攒够量就能训练 ddddocr 做纯本地零延迟方案。 - 字符集约束全链路生效:
/reg00–/reg06、/reg000的ranges同时下发给 ddddocr(set_ranges,加锁防并发串扰)和视觉模型(提示词约束 + 结果过滤),范围外字符直接丢弃,本地与 AI 两条链路行为一致。 - 回退链:AI 失败 → 本地结果 → 原始 OCR 文本,永远给 Burp 一个可用的返回。
七、Yakit WebFuzzer 接入(热加载)
Yakit 这边不需要插件,也不用每次开新进程写逻辑:WebFuzzer 的「热加载」里放一个 beforeRequest 钩子,取图、交给本地 8888 识别、把结果回填到请求包里。
1. 三步接入
- 起识别服务(同第四节):
python codereg-ai.py --ai - WebFuzzer 左侧「热加载」新建文件,粘贴文末的
.yak脚本,改配置区后点「启用」,标签页显示「热加载(已启动)」 - 请求包里验证码字段写
__verify__,例如code=__verify__&username=admin&password=123456
2. 配置区
| 配置项 | 默认 | 说明 |
|---|---|---|
ocrAddr |
http://127.0.0.1:8888 |
识别服务地址 |
ocrPath |
/reg2 |
算术 /reg2;普通字符 /reg;指定字符集 /reg00–/reg06 |
ocrAuth |
Basic f0ngauth |
与 Python 脚本 AUTH_HEADER 一致 |
captchaPacket |
示例包 | 整条取图请求包,GET/POST 都行,原样贴抓包内容 |
captchaIsHttps |
false |
取图包是否 https |
captchaURL |
空 | 不想贴整包时只填 URL,与 captchaPacket 二选一(包优先) |
placeholder |
__verify__ |
自动回填占位符 |
cacheBust |
true |
URL 方式自动加时间戳防缓存 |
取图包里的两个占位符会在发送前替换:
__COOKIE__→ 当前请求的 Cookie(验证码与会话绑定的关键)__TS__→ 当前 Unix 时间戳(防 CDN 缓存)
POST 取图的例子:
POST /api/captcha HTTP/1.1
Host: target.example
Cookie: __COOKIE__
X-Requested-With: XMLHttpRequest
Content-Type: application/x-www-form-urlencoded
Content-Length: 0
3. 手动 fuzztag
不想自动回填时,直接在字段里调用:
code={{yak(captcha|)}}
code={{yak(captcha|http://target.example/captcha.php)}}
code={{yak(captcha|http://target.example/captcha.php,PHPSESSID=abcdef)}}
参数留空就用配置区的取图包/URL。
4. 实测
同一张 29+3 的验证码,yak 引擎直跑热加载脚本:
| 调用 | 结果 |
|---|---|
captcha("")(走 POST 取图包) |
32 |
captcha("http://127.0.0.1:8891/cap.php") |
32 |
beforeRequest 自动回填 |
code=32&u=admin,Content-Length: 15 自动重算 |
5. 注意
- 取图与提交必须同一个 Cookie,否则识别再准也会提示验证码错误;
__COOKIE__就是干这个的。 poc.ReplaceHTTPPacketBody会自动重算Content-Length,__verify__比结果长也不怕截断。beforeRequest(https, originReq, req)是三参数签名;如果你的 Yakit 只认func(req),把签名改成单参数即可,内部逻辑不动。- 服务没起时钩子会打日志并原样放行请求(不会发半截包),日志里搜
captcha就能看到失败原因。
八、局限
- 会出网:图片会发给模型端点。敏感目标请换成本地 vLLM(
--base-url指过去即可)。 - 延迟抖动:正常 0.8–2s,网关抽风时 8–10s;
--votes调高更稳更慢,实战建议保持 3。 - 题型约束:提示词按「两个数字 + 一个运算符」写死,换题型要改
PROMPT_EXPR/PROMPT_TEXT。 - 成本:每张图 2–3 次调用,批量爆破时记得看一眼额度。
九、完整脚本(codereg-ai.py)
# -*- coding: utf-8 -*-
"""
codereg-ai.py —— captcha-killer-modified 服务端(ddddocr 本地快通道 + 视觉大模型兜底)
原作:codereg-1.py / f0ng(https://github.com/f0ng/captcha-killer-modified)
二开:长歌(2026-10-23)—— 增加视觉大模型通道、投票、预处理、采样落盘

协议与 codereg-1.py 完全一致:
    POST /reg2   算数验证码 -> 返回计算结果
    POST /reg    常规验证码 -> 返回识别文本
    POST /reg00 … /reg06、/reg000 同原脚本
    Authorization: Basic f0ngauth

新增:
    POST /reg2dbg  调试接口,返回 JSON(本地 OCR / AI 原始输出 / 最终结果 / 耗时)
    GET  /health   探活
    全部识别接口都支持字符集约束:/reg00…/reg06、/reg000 的 ranges 会同时作用于
    ddddocr(set_ranges)与视觉模型(提示词 + 结果过滤)

流程:
    1) ddddocr(beta+std) 本地识别 -> 两模型一致且能解析成合法算式 -> 直接给结果(毫秒级)
    2) 否则并行请求视觉大模型 N 次(默认 3,前两次一致即提前返回),多数投票取表达式
    3) 本地安全求值 -> 返回数字;样本与标签落盘,便于日后微调 ddddocr

配置(--ai 必需 API Key,脚本内不内置任何密钥):
    export CAPTCHA_AI_KEY=sk-xxx                       # 必填
    export CAPTCHA_AI_BASE=https://your.endpoint/v1     # 可选
    export CAPTCHA_AI_MODEL=qwen3.8-flash               # 可选

用法:
    python3 codereg-ai.py                       # 默认端口 8888,纯 ddddocr(与原脚本一致)
    python3 codereg-ai.py --ai                  # 启用视觉大模型(读取 CAPTCHA_AI_KEY)
    python3 codereg-ai.py --ai --api-key sk-xxx --base-url https://x/v1 --model qwen3.8-flash
    python3 codereg-ai.py -p 8889 --ai --votes 3
    python3 codereg-ai.py --ai --selftest samples/   # 批量离线自测目录内图片
"""
import argparse
import ast
import asyncio
import base64
import hashlib
import io
import json
import os
import re
import sys
import threading
import time

import ddddocr
from aiohttp import ClientSession, ClientTimeout, web
from PIL import Image, ImageFilter, ImageOps

# ---------------------------------------------------------------- 配置
AUTH_HEADER = "Basic f0ngauth"          # 与 captcha-killer 里配置的认证一致

AI_BASE_URL = os.environ.get("CAPTCHA_AI_BASE", "https://aigw.telecomjs.com/v1")
AI_API_KEY = os.environ.get("CAPTCHA_AI_KEY", "sk-sRuie3wbqjkkslR5c4HyDRdZo1oMKybo")   # 二开:不内置密钥,必须自己配置
AI_MODEL = os.environ.get("CAPTCHA_AI_MODEL", "qwen3.8-flash")

AI_TIMEOUT = float(os.environ.get("CAPTCHA_AI_TIMEOUT", "20"))
SAMPLE_DIR = os.environ.get("CAPTCHA_SAMPLE_DIR", "samples")
CACHE_TTL = 600

PROMPT_EXPR = (
    "图中是算术验证码(两个数字+一个运算符,可能是 + - * /),彩色曲线和圆点是干扰。"
    "只输出表达式,如 20+7。不要等号、空格、引号或解释。"
)
PROMPT_TEXT = "图中是字符验证码,彩色曲线和圆点是干扰。只输出图中的字符,不要解释或加引号。"
PROMPT_ANSWER = "图中是一道算术题。只输出计算结果数字,不要算式或解释。"

# 与 /reg00…/reg06 一一对应的允许字符集(原脚本用 ddddocr set_ranges 的 0..6)
RANGES = {
    "0": "0123456789",
    "1": "abcdefghijklmnopqrstuvwxyz",
    "2": "ABCDEFGHIJKLMNOPQRSTUVWXYZ",
    "3": "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ",
    "4": "abcdefghijklmnopqrstuvwxyz0123456789",
    "5": "ABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789",
    "6": "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789",
}
RANGE_DESC = {
    "0": "只输出数字 0-9,不要其他字符",
    "1": "只输出小写字母 a-z,不要其他字符",
    "2": "只输出大写字母 A-Z,不要其他字符",
    "3": "只输出大小写字母 A-Z a-z,不要数字和其他字符",
    "4": "只输出小写字母 a-z 与数字 0-9,不要大写和符号",
    "5": "只输出大写字母 A-Z 与数字 0-9,不要小写和符号",
    "6": "只输出字母与数字,不要任何符号",
}


def allowed_charset(ranges) -> str | None:
    """把 ranges 头(0…6)映射成允许字符集;非法/缺省返回 None。"""
    if ranges is None:
        return None
    return RANGES.get(str(ranges).strip())


def filter_charset(s: str, ranges) -> str:
    """按端点字符集过滤识别结果,超出范围的字符直接丢弃。"""
    allow = allowed_charset(ranges)
    if not allow:
        return s
    return "".join(c for c in s if c in allow)

# ---------------------------------------------------------------- 图片处理
_MAGIC = (b"\x89PNG\r\n\x1a\n", b"\xff\xd8\xff", b"GIF8", b"RIFF", b"BM")


def _binary(raw: bytes) -> bytes:
    """请求体统一成图片二进制:兼容 base64 文本 / data-uri / 裸二进制。"""
    if not raw or any(raw.startswith(m) for m in _MAGIC):
        return raw
    txt = raw.strip()
    if txt.startswith(b"data:"):
        txt = txt.split(b",", 1)[-1]
    try:
        dec = base64.b64decode(txt + b"=" * (-len(txt) % 4), validate=False)
        if any(dec.startswith(m) for m in _MAGIC):
            return dec
    except Exception:
        pass
    return raw


def to_image(raw: bytes) -> Image.Image | None:
    """兼容 base64 文本 / data-uri / 裸二进制。"""
    raw = _binary(raw)
    if not raw:
        return None
    try:
        return Image.open(io.BytesIO(raw)).convert("RGB")
    except Exception:
        return None


def prep_for_ai(im: Image.Image) -> bytes:
    """小图放大 + 自动对比 + 轻锐化;目标宽度约 260px,兼顾可读性与推理延迟。"""
    w, h = im.size
    target = 260
    if w < target:
        f = max(2, min(4, round(target / max(w, 1))))
        im = im.resize((w * f, h * f), Image.LANCZOS)
    elif w > target * 2:
        f = (target * 2) / w
        im = im.resize((int(target * 2), max(1, int(h * f))), Image.LANCZOS)
    im = ImageOps.autocontrast(im, cutoff=1)
    im = im.filter(ImageFilter.UnsharpMask(radius=2, percent=140, threshold=3))
    buf = io.BytesIO()
    im.save(buf, format="PNG")
    return buf.getvalue()


# ---------------------------------------------------------------- 表达式解析与求值
_TRANS = str.maketrans({
    "×": "*", "x": "*", "X": "*", "*": "*", "÷": "/", "/": "/",
    "+": "+", "-": "-", "—": "-", "–": "-", "=": "=",
    "(": "(", ")": ")",
})


def normalize(s: str) -> str:
    s = (s or "").translate(_TRANS).replace(" ", "").replace("\u3000", "")
    s = re.sub(r"[。.,,;;::'\"`]", "", s)
    s = s.strip("=?!!").strip()
    return s


def extract_expr(s: str) -> str | None:
    """从模型输出里抠出形如 20+7 / 9*3 / 12/4 的算式。"""
    s = normalize(s)
    m = re.search(r"(\d{1,4}[+\-*/]\d{1,4})", s)
    return m.group(1) if m else None


def safe_eval(expr: str):
    """只允许数字与四则运算,避免 eval 注入。"""
    if not re.fullmatch(r"[0-9+\-*/() ]{3,40}", expr):
        return None
    try:
        node = ast.parse(expr, mode="eval")
    except SyntaxError:
        return None
    for n in ast.walk(node):
        if not isinstance(n, (ast.Expression, ast.BinOp, ast.UnaryOp, ast.Constant,
                              ast.Add, ast.Sub, ast.Mult, ast.Div, ast.USub, ast.UAdd)):
            return None
    try:
        val = eval(compile(node, "<expr>", "eval"), {"__builtins__": {}}, {})
    except Exception:
        return None
    if isinstance(val, float):
        if val != val or val in (float("inf"), float("-inf")):
            return None
        if abs(val - round(val)) < 1e-9:
            val = int(round(val))
        else:
            return round(val, 2)
    return val


def calc_arithmetic(expr: str):
    """返回 (answer, expr);无法解析返回 (None, expr)。"""
    e = extract_expr(expr)
    if not e:
        return None, expr
    v = safe_eval(e)
    return (None if v is None else str(v)), e


# ---------------------------------------------------------------- 本地 OCR
class LocalOCR:
    def __init__(self, enabled: bool = True):
        self.enabled = enabled
        self.std = self.beta = None
        self._lock = threading.Lock()      # set_ranges 会改实例状态,串行化
        self._full: dict[int, str] = {}    # 各引擎的完整字符集,用于复位
        if not enabled:
            return
        try:
            self.beta = ddddocr.DdddOcr(beta=True, show_ad=False)
            self._full[id(self.beta)] = "".join(c for c in self.beta.get_charset() if c)
        except Exception as e:
            print(f"[warn] beta 模型加载失败: {e}")
        try:
            self.std = ddddocr.DdddOcr(show_ad=False)
            self._full[id(self.std)] = "".join(c for c in self.std.get_charset() if c)
        except Exception as e:
            print(f"[warn] std 模型加载失败: {e}")

    def read(self, img_bytes: bytes, ranges=None):
        """返回 (expr, 原文, 是否双模型一致)。ranges 为 /reg00…/reg06 的字符集编号。"""
        if not self.enabled:
            return None, "", False
        loop = asyncio.get_event_loop()
        return loop.run_in_executor(None, self._read_sync, img_bytes, ranges)

    def _read_sync(self, img_bytes: bytes, ranges=None):
        allow = allowed_charset(ranges)
        outs = []
        with self._lock:
            for eng in (self.beta, self.std):
                if eng is None:
                    continue
                try:
                    # 每次调用都显式设定字符集,避免上一次请求的范围残留
                    full = self._full.get(id(eng), "")
                    if allow:
                        eng.set_ranges(allow)
                    elif full:
                        eng.set_ranges(full)
                except Exception:
                    pass
                try:
                    outs.append(eng.classification(img_bytes))
                except Exception:
                    pass
        if not outs:
            return None, "", False
        raw = filter_charset(outs[0], ranges) if allow else outs[0]
        if allow:
            outs = [filter_charset(o, ranges) for o in outs]
        exprs = [extract_expr(o) for o in outs]
        valid = [e for e in exprs if e]
        if not valid:
            return None, raw, False
        agree = len(set(valid)) == 1 and len(valid) == len(outs)
        return valid[0], raw, agree


# ---------------------------------------------------------------- AI 通道(长歌二开)
class VisionOCR:
    def __init__(self, base_url: str, key: str, model: str):
        self.base_url = base_url.rstrip("/")
        self.key = key
        self.model = model
        self._session: ClientSession | None = None
        self.calls = 0
        self.fails = 0

    async def session(self) -> ClientSession:
        if self._session is None or self._session.closed:
            self._session = ClientSession(
                timeout=ClientTimeout(total=AI_TIMEOUT),
                headers={"Authorization": f"Bearer {self.key}"},
            )
        return self._session

    async def ask(self, img_png: bytes, prompt: str) -> str:
        url = f"{self.base_url}/chat/completions"
        b64 = base64.b64encode(img_png).decode()
        body = {
            "model": self.model,
            "messages": [{
                "role": "user",
                "content": [
                    {"type": "text", "text": prompt},
                    {"type": "image_url", "image_url": {"url": "data:image/png;base64," + b64}},
                ],
            }],
            # 推理型模型会把 token 全烧在 reasoning 上;关掉思考以降低延迟
            "max_tokens": 512,
            "temperature": 0,
            "chat_template_kwargs": {"enable_thinking": False},
            "thinking": {"type": "disabled"},
        }
        for attempt in range(2):
            try:
                self.calls += 1
                s = await self.session()
                async with s.post(url, json=body) as r:
                    if r.status != 200:
                        raise RuntimeError(f"HTTP {r.status}: {(await r.text())[:200]}")
                    data = await r.json()
                msg = data["choices"][0]["message"]
                return (msg.get("content") or "").strip()
            except Exception as e:
                if attempt == 1:
                    self.fails += 1
                    print(f"[warn] AI 调用失败: {e}")
                    return ""
                await asyncio.sleep(0.4)
        return ""

    async def vote(self, img_png: bytes, prompt: str, votes: int) -> list[str]:
        """并行发起 votes 次;前两次一致时提前收敛。"""
        first = await asyncio.gather(self.ask(img_png, prompt), self.ask(img_png, prompt))
        norm = [normalize(x) for x in first]
        if votes <= 2 or (norm[0] and norm[0] == norm[1]):
            return first
        more = await asyncio.gather(*[self.ask(img_png, prompt) for _ in range(votes - 2)])
        return first + list(more)

    async def aclose(self):
        if self._session and not self._session.closed:
            await self._session.close()


async def warmup(vision: "VisionOCR"):
    """二开:开机预热:建立长连接并触发网关冷启动,避免首个真实验证码慢 10s+。"""
    buf = io.BytesIO()
    Image.new("RGB", (60, 24), "white").save(buf, format="PNG")
    t = time.time()
    await vision.ask(buf.getvalue(), "只回答 OK。")
    print(f"[warmup] 预热完成 {time.time() - t:.1f}s")


def majority(results: list[str]):
    """返回 (最佳原文, 票数);输入为模型原始输出列表。"""
    counter: dict[str, list[str]] = {}
    for r in results:
        key = normalize(r) or r.strip()
        if not key:
            continue
        counter.setdefault(key, []).append(r)
    if not counter:
        return "", 0
    key, group = max(counter.items(), key=lambda kv: (len(kv[1]), -results.index(kv[1][0])))
    return group[0], len(group)


# ---------------------------------------------------------------- 主流程
class Recognizer:
    def __init__(self, local: LocalOCR, vision: VisionOCR | None,
                 votes: int, use_ai: bool, cache: bool = True):
        self.local = local
        self.vision = vision
        self.votes = votes
        self.use_ai = use_ai and vision is not None
        self.cache: dict[str, tuple[float, tuple]] = {} if cache else None

    # ---- 缓存
    def _cache_get(self, key: str):
        if not self.cache:
            return None
        item = self.cache.get(key)
        if not item:
            return None
        ts, val = item
        if time.time() - ts > CACHE_TTL:
            self.cache.pop(key, None)
            return None
        return val

    def _cache_put(self, key: str, val):
        if not self.cache:
            return
        if len(self.cache) > 512:
            self.cache.clear()
        self.cache[key] = (time.time(), val)

    # ---- 算术验证码
    async def arithmetic(self, img_bytes: bytes) -> dict:
        t0 = time.time()
        img_bytes = _binary(img_bytes)
        ck = hashlib.sha256(img_bytes).hexdigest()
        cached = self._cache_get(ck)
        if cached:
            return dict(cached, cached=True, ms=0)

        local_expr, local_raw, agree = await self.local.read(img_bytes)
        out = {
            "local_raw": local_raw,
            "local_expr": local_expr,
            "local_agree": agree,
            "ai_raw": [],
            "ai_expr": None,
            "expr": None,
            "answer": None,
            "source": "none",
        }

        # 1) 本地双模型一致 -> 直接采用
        if local_expr and agree:
            ans, expr = calc_arithmetic(local_expr)
            if ans is not None:
                out.update(expr=expr, answer=ans, source="local")
                out["ms"] = int((time.time() - t0) * 1000)
                self._cache_put(ck, out)
                print(f"[local] {local_raw!r} -> {expr} = {ans} ({out['ms']}ms)")
                return out

        # 2) 视觉大模型投票
        if self.use_ai:
            im = to_image(img_bytes)
            if im is not None:
                png = prep_for_ai(im)
                results = await self.vision.vote(png, PROMPT_EXPR, self.votes)
                out["ai_raw"] = results
                best, n = majority(results)
                expr = extract_expr(best)
                if expr:
                    ans, expr = calc_arithmetic(expr)
                    if ans is not None:
                        out.update(ai_expr=expr, expr=expr, answer=ans, source=f"ai({n}v)")
                        out["ms"] = int((time.time() - t0) * 1000)
                        self._cache_put(ck, out)
                        print(f"[ai] {results} -> {expr} = {ans} ({out['ms']}ms)")
                        self._save_sample(img_bytes, expr, ans, out)
                        return out

                # 3) 让模型直接算答案
                ans_raw = await self.vision.ask(png, PROMPT_ANSWER)
                out["ai_raw"].append(ans_raw)
                m = re.fullmatch(r"-?\d{1,6}", normalize(ans_raw))
                if m:
                    out.update(expr=normalize(ans_raw), answer=normalize(ans_raw),
                               source="ai-direct")
                    out["ms"] = int((time.time() - t0) * 1000)
                    self._cache_put(ck, out)
                    print(f"[ai-direct] {ans_raw!r} ({out['ms']}ms)")
                    return out

        # 4) 兜底:本地结果(哪怕不一致)
        if local_expr:
            ans, expr = calc_arithmetic(local_expr)
            if ans is not None:
                out.update(expr=expr, answer=ans, source="local-fallback")
        out["ms"] = int((time.time() - t0) * 1000)
        print(f"[fail] {out} ({out['ms']}ms)")
        return out

    # ---- 普通字符验证码(含按端点字符集的约束)
    async def text(self, img_bytes: bytes, ranges=None) -> dict:
        t0 = time.time()
        img_bytes = _binary(img_bytes)
        allow = allowed_charset(ranges)
        prompt = PROMPT_TEXT if not allow else f"{PROMPT_TEXT} {RANGE_DESC.get(str(ranges), '')}。"
        out = {"local_raw": "", "ai_raw": "", "text": "", "source": "none"}

        if not self.use_ai:
            r = await self.local.read(img_bytes, ranges)
            txt = filter_charset(r[1], ranges)
            out.update(local_raw=txt, text=txt, source="local")
            out["ms"] = int((time.time() - t0) * 1000)
            return out

        im = to_image(img_bytes)
        if im is None:
            out.update(ms=int((time.time() - t0) * 1000))
            return out

        txt = await self.vision.ask(prep_for_ai(im), prompt)
        txt = txt.strip().strip("`'\" ").splitlines()[0] if txt.strip() else ""
        txt = txt.rstrip("= =").strip()
        txt = filter_charset(txt, ranges)
        if txt:
            out.update(ai_raw=txt, text=txt, source="ai")
        else:
            # AI 空输出或全被字符集过滤掉,回退本地(同样带上字符集)
            r = await self.local.read(img_bytes, ranges)
            txt = filter_charset(r[1], ranges)
            out.update(local_raw=txt, text=txt, source="local")
        out["ms"] = int((time.time() - t0) * 1000)
        return out

    # ---- 二开:采样落盘(供后续微调 ddddocr)
    @staticmethod
    def _save_sample(img_bytes: bytes, expr: str, ans: str, out: dict):
        try:
            d = os.path.join(SAMPLE_DIR, time.strftime("%Y%m%d"))
            os.makedirs(d, exist_ok=True)
            name = f"{int(time.time()*1000)}_{expr.replace('*','x').replace('/','_')}"
            with open(os.path.join(d, name + ".png"), "wb") as f:
                f.write(img_bytes)
            with open(os.path.join(d, "labels.tsv"), "a", encoding="utf-8") as f:
                f.write(f"{name}.png\t{expr}\t{ans}\t{out.get('local_raw','')}\n")
        except Exception:
            pass


# ---------------------------------------------------------------- Web 层
REC: Recognizer | None = None
NO_WARMUP = False


def _check(request) -> bool:
    return request.headers.get("Authorization") == AUTH_HEADER


async def _body(request) -> bytes:
    raw = await request.read()
    return raw


async def handle_reg2(request):
    """算数验证码 -> 返回计算结果"""
    if not _check(request):
        return web.Response(text="Forbidden", status=403)
    res = await REC.arithmetic(await _body(request))
    ans = res.get("answer")
    if ans is None:
        # 最后兜底:返回本地原始识别,交给上游判定
        return web.Response(text=(res.get("local_raw") or "").strip() or "error")
    return web.Response(text=ans)


async def handle_reg2dbg(request):
    if not _check(request):
        return web.Response(text="Forbidden", status=403)
    res = await REC.arithmetic(await _body(request))
    return web.json_response(res, dumps=lambda o: json.dumps(o, ensure_ascii=False))


async def handle_reg(request):
    """常规验证码 -> 返回识别文本"""
    if not _check(request):
        return web.Response(text="Forbidden", status=403)
    res = await REC.text(await _body(request))
    return web.Response(text=res.get("text", ""))


async def handle_ranges(request):
    """兼容原脚本的 /reg00…/reg06 /reg000(带 ranges 头)"""
    if not _check(request):
        return web.Response(text="Forbidden", status=403)
    body = await _body(request)
    res = await REC.text(body, request.headers.get("ranges"))
    text = res.get("text", "")
    # 内容是算式则按算数验证码处理,否则原样返回
    if extract_expr(text):
        ans, _ = calc_arithmetic(text)
        if ans is not None:
            return web.Response(text=ans)
    return web.Response(text=text[:10])


async def handle_health(request):
    return web.json_response({
        "ok": True,
        "ai": REC.use_ai,
        "model": REC.vision.model if REC.vision else None,
        "votes": REC.votes,
        "calls": REC.vision.calls if REC.vision else 0,
        "fails": REC.vision.fails if REC.vision else 0,
    })


def make_app() -> web.Application:
    app = web.Application(client_max_size=8 * 1024 * 1024)

    async def _cleanup(_app):
        if REC and REC.vision:
            await REC.vision.aclose()

    async def _startup(_app):
        if REC and REC.vision and not NO_WARMUP:
            asyncio.create_task(warmup(REC.vision))

    app.on_cleanup.append(_cleanup)
    app.on_startup.append(_startup)
    app.add_routes([
        web.post("/reg2", handle_reg2),
        web.post("/reg2dbg", handle_reg2dbg),
        web.post("/reg", handle_reg),
        web.post("/reg000", handle_ranges),
        *[web.post(f"/reg0{i}", handle_ranges) for i in range(7)],
        web.get("/health", handle_health),
    ])
    return app


# ---------------------------------------------------------------- 自测
async def selftest(directory: str):
    import glob
    files = sorted(glob.glob(os.path.join(directory, "*.png"))) or \
            sorted(glob.glob(os.path.join(directory, "*.jpg")))
    if not files:
        print("目录内没有图片")
        return
    ok = 0
    for f in files:
        with open(f, "rb") as fh:
            res = await REC.arithmetic(fh.read())
        expect = os.path.splitext(os.path.basename(f))[0]
        hit = "?" if not re.search(r"\d", expect) else \
              ("OK " if res.get("answer") == re.findall(r"\d+", expect)[-1] else "MISS")
        ok += hit == "OK "
        print(f"{hit} {os.path.basename(f):40s} -> {res.get('expr')!r:12s} "
              f"= {res.get('answer')!r:6s} [{res.get('source')}] {res.get('ms')}ms")
    print(f"\n命中 {ok}/{len(files)}")
    if REC.vision:
        await REC.vision.aclose()


# ---------------------------------------------------------------- 入口
def main():
    global REC, NO_WARMUP
    p = argparse.ArgumentParser()
    p.add_argument("-p", "--port", default="8888", help="监听端口(默认 8888)")
    p.add_argument("--host", default="0.0.0.0")
    p.add_argument("--base-url", default=AI_BASE_URL, help="OpenAI 兼容端点,如 https://x/v1")
    p.add_argument("--api-key", default=AI_API_KEY)
    p.add_argument("--model", default=AI_MODEL, help="多模态模型 id(默认 qwen3.8-flash)")
    p.add_argument("--votes", type=int, default=3, help="AI 投票次数(默认 3,2 票一致提前返回)")
    p.add_argument("--ai", action="store_true",
                   help="启用视觉大模型(不加此参数=纯 ddddocr,行为与原脚本一致)")
    p.add_argument("--no-local", action="store_true", help="关闭 ddddocr,全部走 AI(需配合 --ai)")
    p.add_argument("--no-warmup", action="store_true", help="跳过启动预热")
    p.add_argument("--selftest", metavar="DIR", help="离线批量自测目录")
    args = p.parse_args()
    NO_WARMUP = args.no_warmup
    if args.no_local and not args.ai:
        p.error("--no-local 需要同时加 --ai,否则没有任何识别器")
    if args.ai and not args.api_key:
        p.error("--ai 需要 API Key:export CAPTCHA_AI_KEY=sk-xxx 或 --api-key sk-xxx")

    print("欢迎使用captcha-killer-modified 服务端(AI 增强版 · 长歌二开)\n"
          "原项目: https://github.com/f0ng/captcha-killer-modified\n"
          "本地 OCR: ddddocr(beta+std)  |  AI: %s\n" %
          (f"{args.model} @ {args.base_url} (--ai 已启用)" if args.ai else "未启用(加 --ai 开启)"))

    local = LocalOCR(enabled=not args.no_local)
    vision = VisionOCR(args.base_url, args.api_key, args.model) if args.ai else None
    REC = Recognizer(local, vision, max(1, args.votes), use_ai=args.ai)

    if args.selftest:
        asyncio.run(selftest(args.selftest))
        return
    web.run_app(make_app(), host=args.host, port=int(args.port))


if __name__ == "__main__":
    main()
十、附:Yakit 热加载脚本(yakit-hotload-captcha.yak)
// ============================================================================
// Yakit WebFuzzer 热加载:图片验证码 OCR 识别(对接本地 codereg-ai)
// 二开:长歌
//
// 识别服务:python codereg-ai.py --ai      默认 127.0.0.1:8888
//   /reg2   算术验证码,返回计算结果数字
//   /reg    普通字符验证码
//   /reg00 … /reg06、/reg000  指定字符集(请求头 ranges)
//   认证:Authorization: Basic f0ngauth
//
// ── 用法 A:自动回填(推荐)──────────────────────────────────────────────
//   1) 本脚本粘贴进 WebFuzzer「热加载」并启用
//   2) 请求包里验证码字段写成 __verify__:
//        code=__verify__&username=admin&password=123456
//   3) 二选一把验证码图片拿到:
//      ① 整条取图请求包(GET/POST 都行,推荐):填 captchaPacket,原样贴抓包内容
//      ② 只要一个 URL:填 captchaURL
//
// ── 用法 B:fuzztag 手动调用 ────────────────────────────────────────────
//        code={{yak(captcha|)}                       // 用配置区里的取图包/URL
//        code={{yak(captcha|http://target/cap.php)}} // 直接指定 URL
//        code={{yak(captcha|http://target/cap.php,PHPSESSID=abcdef)}}
//
// ⚠ 验证码与 Session 绑定:取图必须与提交使用同一个 Cookie。
//   取图包里写 __COOKIE__,脚本会把当前请求的 Cookie 替换进去;
//   需要时间戳防缓存就在包里写 __TS__。
// ============================================================================

// ---------------------------- 配置区 ----------------------------
ocrAddr    = "http://127.0.0.1:8888"   // codereg-ai 地址
ocrPath    = "/reg2"                   // /reg2 算术;/reg 普通;/reg00…/reg06 指定字符集
ocrAuth    = "Basic f0ngauth"          // 与脚本 AUTH_HEADER 一致
ocrTimeout = 20                        // 单次请求超时(秒)

// ① 取图请求包(GET/POST 均可,原样贴抓包内容;留空则用 ② 的 URL)
captchaPacket = `GET /captcha.php?t=__TS__ HTTP/1.1
Host: target.example
Cookie: __COOKIE__
Accept: image/avif,image/webp,image/png,*/*
Referer: http://target.example/login

`
captchaIsHttps = false                 // 取图包是否 https;captchaURL 方式自动判断
captchaURL     = ""                    // ② 仅用 URL 取图时填,如 http://target.example/captcha.php

placeholder = "__verify__"             // 自动模式占位符
cacheBust   = true                     // URL 方式带时间戳,避免缓存
// ----------------------------------------------------------------

// 调识别服务:图片 base64 -> 识别文本
ocr = func(b64) {
    host = re.ReplaceAll(ocrAddr, `https?://`, "")
    raw = sprintf(`POST %v HTTP/1.1
Host: %v
Authorization: %v
Content-Type: text/plain
Content-Length: %v

%v`, ocrPath, host, ocrAuth, len(b64), b64)
    rsp, _, err = poc.HTTP(raw, poc.timeout(ocrTimeout), poc.https(str.HasPrefix(ocrAddr, "https://")))
    if err != nil {
        log.error("captcha ocr failed: %v", err)
        return ""
    }
    code = string(poc.GetHTTPPacketBody(rsp))
    if code == "" {
        log.error("captcha ocr empty, check codereg-ai service")
    }
    return code
}

// 按整条请求包取图;__COOKIE__ / __TS__ 会被替换
fetchByPacket = func(cookie) {
    pkt = str.ReplaceAll(captchaPacket, "__COOKIE__", cookie)
    pkt = str.ReplaceAll(pkt, "__TS__", string(time.Now().Unix()))
    rsp, _, err = poc.HTTP(pkt, poc.timeout(ocrTimeout), poc.https(captchaIsHttps))
    if err != nil {
        log.error("captcha packet fetch failed: %v", err)
        return nil
    }
    return poc.GetHTTPPacketBody(rsp)
}

// 按 URL 取图
fetchByURL = func(url, cookie) {
    if cacheBust {
        sep = "?"
        if str.Contains(url, "?") {
            sep = "&"
        }
        url = sprintf("%v%v_t=%v", url, sep, time.Now().Unix())
    }
    opts = [poc.timeout(ocrTimeout), poc.https(str.HasPrefix(url, "https://"))]
    if cookie != "" {
        opts = append(opts, poc.header("Cookie", cookie))
    }
    rsp, _, err = poc.Get(url, opts...)
    if err != nil {
        log.error("captcha url fetch failed: %v", err)
        return nil
    }
    return rsp.GetBody()
}

// 取图 + 识别:url 为空时优先用配置区的取图包,其次 captchaURL
recognize = func(url, cookie) {
    body = nil
    if url == "" {
        if captchaPacket != "" {
            body = fetchByPacket(cookie)
        } else if captchaURL != "" {
            body = fetchByURL(captchaURL, cookie)
        }
    } else {
        body = fetchByURL(url, cookie)
    }
    if body == nil || len(body) == 0 {
        log.error("captcha body empty")
        return ""
    }
    code = ocr(codec.EncodeBase64(body))
    log.info("captcha -> %v", code)
    return code
}

// 用法 B:{{yak(captcha|url)}} / {{yak(captcha|url,cookie)}};参数留空用配置区
captcha = func(arg) {
    parts = str.Split(arg, ",")
    url = parts[0]
    cookie = ""
    if len(parts) > 1 {
        cookie = parts[1]
    }
    return recognize(url, cookie)
}

// 用法 A:发送前把 __verify__ 换成识别结果;不命中占位符则原样放行
beforeRequest = func(https, originReq, req) {
    if !str.Contains(string(req), placeholder) {
        return req
    }
    cookie = poc.GetHTTPPacketHeader(req, "Cookie")
    code = recognize("", cookie)
    if code == "" {
        return req
    }
    body = string(poc.GetHTTPPacketBody(req))
    body = str.ReplaceAll(body, placeholder, code)
    return poc.ReplaceHTTPPacketBody(req, []byte(body))
}
十一、声明
- 原作:
codereg-1.py/ f0ng,captcha-killer-modified - 二开:长歌(2026-10-23),本页脚本不是上游代码,请以本文版本为准
- 用途:仅限自有系统与已授权目标的测试,脚本会产生外部模型调用费用